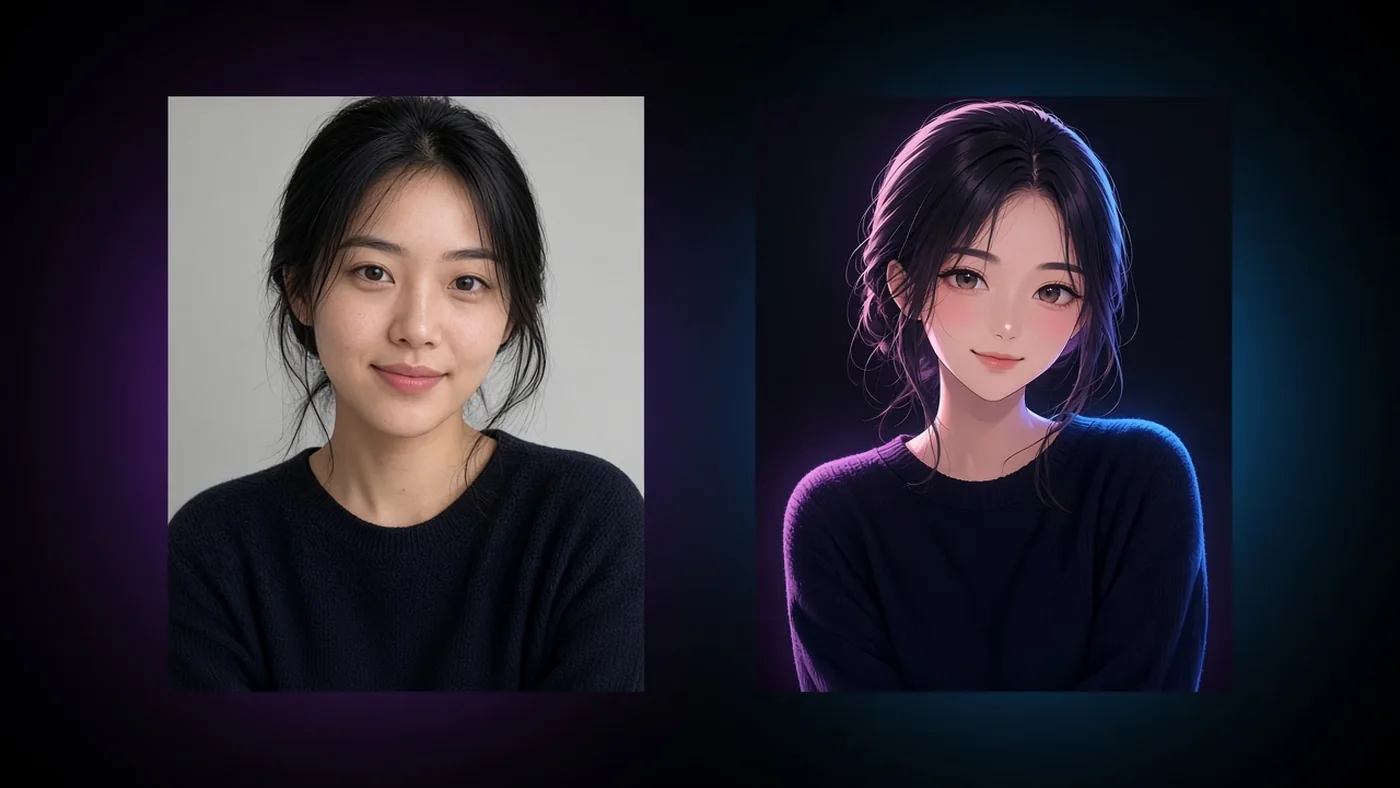
用我的照片生成 VTuber AI,是空白提示詞顯得沒意義時,人們會下的搜尋。他們已經知道自己在鏡頭裡長什麼樣子。他們想把那張靜態照變成可以繼續編輯的動漫風直播基底,而不是另一張漂亮、卻沒有去處的 PNG。
BeTuber 的照片流程做的就是這件事:一張人像進去,一個腰部以上的角色基底出來,存在你的模型庫裡,讓練習和直播待在同一個地方。
結果本身,先不談推銷
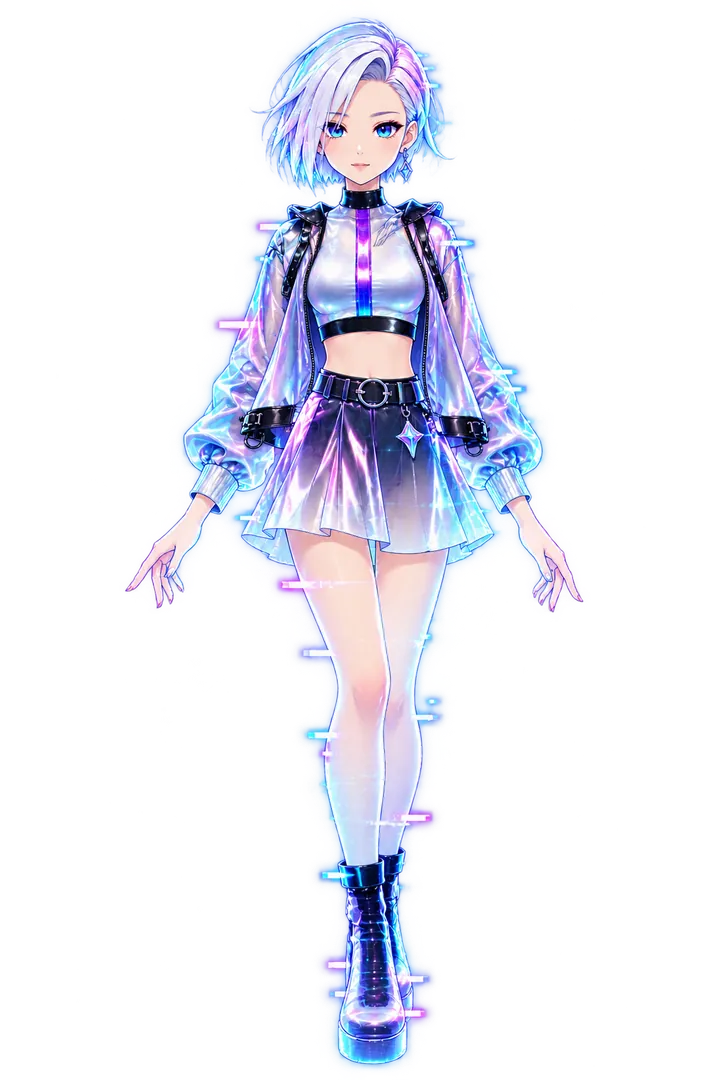
上傳一張清楚的人像。BeTuber 從照片讀取頭髮、臉型和服裝線索,做出動漫風、腰部以上的基底。生成結束時,那個基底是工作室裡的角色,不是用過即丟的下載檔。
你不需要 Live2D Cubism 或另一套追蹤器才能開始。免費額度涵蓋從你的照片做出的第一個基底。手勢和基礎項目之後用工作室代幣解鎖,等你真的想讓臉在直播上有反應的時候。
為什麼用照片,而不是提示詞
你心裡只有一種氣氛時,提示詞有用。目標是神似時,它們就吃力。照片已經握著難的細節:頭髮怎麼落下、五官怎麼坐、你不假思索會穿的顏色。
一般的圖像聊天可以畫出銳利的東西,然後把檔案留在下載資料夾。BeTuber 把輸出留成產品裡的角色,所以下一步是編輯和直播,不是再去找另一個工具。
每個帳號可以從照片得到一次免費基底。之後,表演解鎖用的是和 BeTuber 其他功能同一個代幣錢包。這個限制是故意的,好讓免費層保持誠實。
步驟
- 用上方的按鈕,以 Google、Discord 或 Twitch 註冊。
- 上傳一張清楚的人像:面向鏡頭、光線好、眼睛看得到。
- 生成,並等基底進到模型庫。
- 想要表情和手時,用代幣解鎖手勢和基礎項目。
- 繼續在模型庫裡調整,想要一個可以分享的直播網址時再播。
真正有幫助的照片技巧
面向鏡頭。柔和的日光或普通的室內光,勝過重濾鏡。把頭髮和肩膀放進畫面;BeTuber 取的是腰部以上,所以切到下巴的自拍會丟掉有用的輪廓。背景保持簡單。雜亂的房間和有圖案的牆,比人們預期的更常被誤認成衣服。
如果第一次已經接近,就解鎖基礎項目並在模型庫裡調整。沒有第二次免費額度。
基底之後
基底只是開始。手勢和基礎項目讓表情在聊天室裡讀得出來。想要舞台時加上場景。想要別人可以打開的直播網址時再播。
做出外觀,練習那張臉,覺得準備好了再直播。照片生成放在這個循環的最前面,所以你不會在試過追蹤之前,就卡在提示詞裡發明一個陌生人。
結論
上傳一張真實人像,留下仍然像你的動漫風基底,只在解鎖會表演的那些層時才花代幣。在上方註冊,領取免費基底,再從那裡做起。