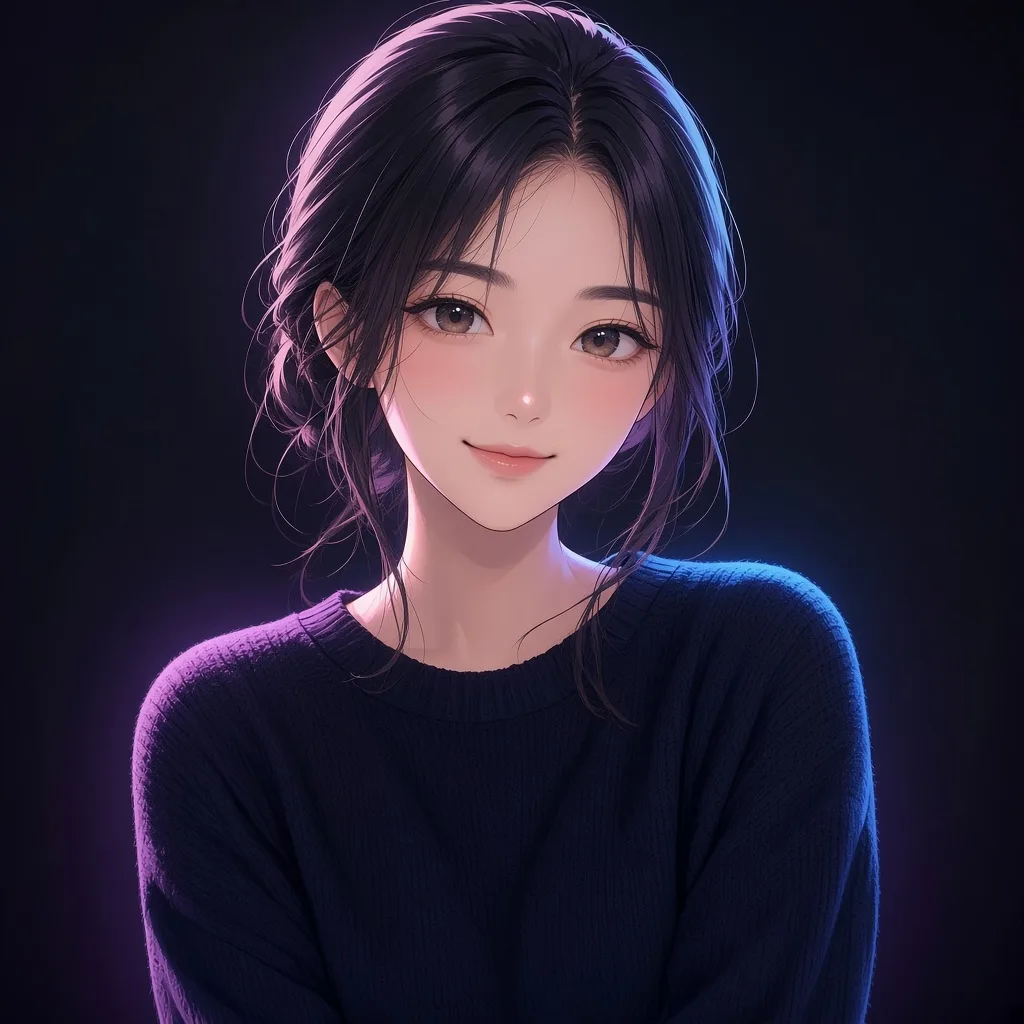
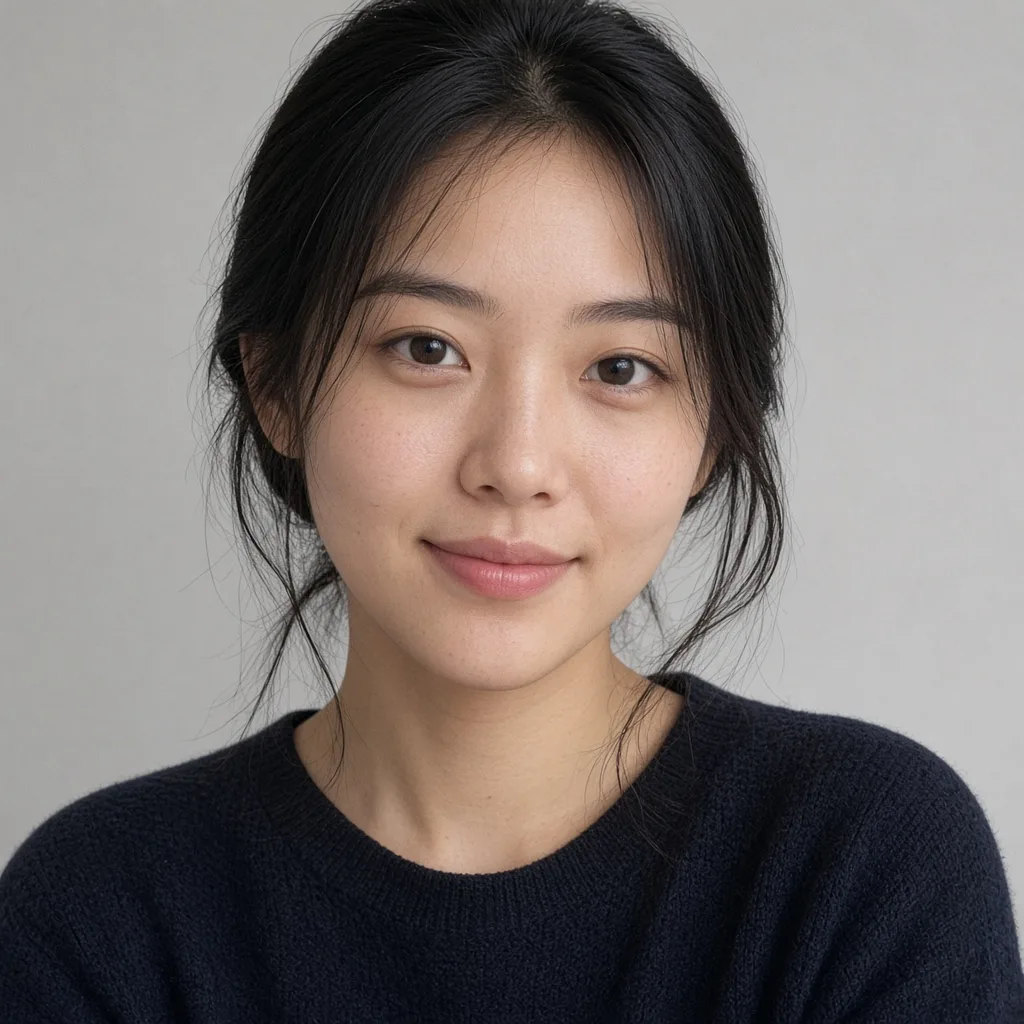
写真でVTuber AIを生成するは、空のプロンプトに疲れたときの検索です。カメラ映りはもう分かっている。その静止画を、編集を続けられる配信用のアニメベースにしたいのであって、行き場のないきれいなPNGが欲しいわけではありません。
BeTuberの写真フローは、ポートレート1枚から腰上のベースを作り、Modelsに保存します。練習も配信も同じ場所から続きます。
出てくるもの
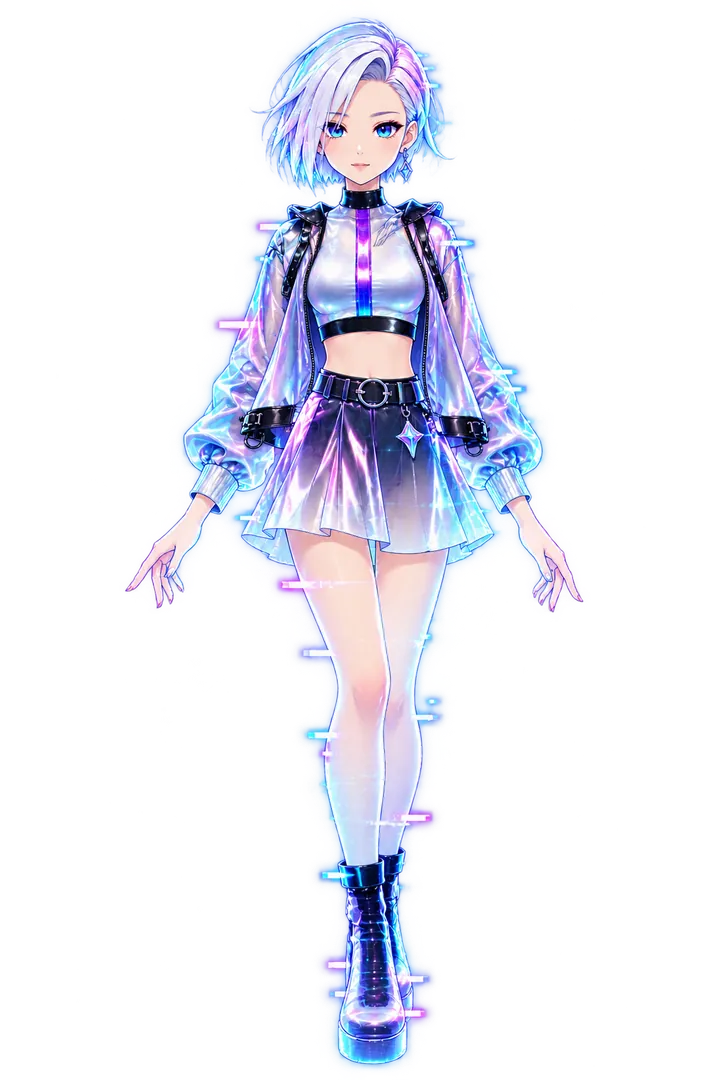
クリアなポートレートをアップロードします。BeTuberは髪・顔立ち・服の手がかりを写真から読み取り、アニメイラスト風の腰上ベースを作ります。生成が終わると、それはスタジオのキャラです。使い捨てダウンロードではありません。
始めるだけなら Cubism も別トラッカーも不要です。無料クレームは写真からの最初のベース。ジェスチャーとBasicsは、配信で顔を動かしたくなったときにトークンで解除します。
プロンプトだけより写真が向く理由
プロンプトはムードだけ決まっているときに効きます。似姿がゴールだと弱いです。写真には髪の落ち方、顔のバランス、無意識に着る色といった難しい情報がすでに入っています。
汎用の画像チャットはシャープな絵を出して Downloads に置き去りにすることが多いです。BeTuberは結果をプロダクト内のキャラとして残すので、次の一手は編集と配信であり、別ツール探しではありません。
アカウントごとに写真からのベースは1回無料です。その後のパフォーマンス解除は、BeTuberの他機能と同じトークン財布を使います。無料枠をはっきりさせるための制限です。
手順
- 上のボタンから Google / Discord / Twitch で登録する。
- クリアなポートレートを1枚送る。正面、明るい光、目が見える。
- 生成し、ベースが Models に入るのを待つ。
- 表情や手が欲しくなったらトークンでジェスチャーとBasicsを解除する。
- Models で詰め、共有できるライブURLが欲しくなったら配信へ。
効く写真のコツ
カメラ目線。柔らかい昼光や素直な室内光は、強いフィルタに勝ちます。髪と肩を入れる。BeTuberは腰上なので、あごで切った自撮りは使えるシルエットを捨てます。背景はシンプルに。散らかった部屋や模様のある壁は、想像以上に「服」と誤認されます。
一発目が近いなら、Basicsを解除して Models で寄せる。無料クレームの二度目はありません。
ベースのあと
ベースは入り口です。ジェスチャーとBasicsでチャットに読める表情がつき、シーンで舞台が足せ、Streamで人が開けるURLができます。
見た目を作る。顔を練習する。準備ができたと感じたら配信する。写真生成はその先頭にあるので、トラッキングを試す前にプロンプトで見知らぬ人を設計し続けなくて済みます。
まとめ
実写ポートレートを上げて、まだ自分らしいアニメベースを残し、演じる層を解除するときだけトークンを使う。上から登録し、無料ベースを受け取り、そこから積む。